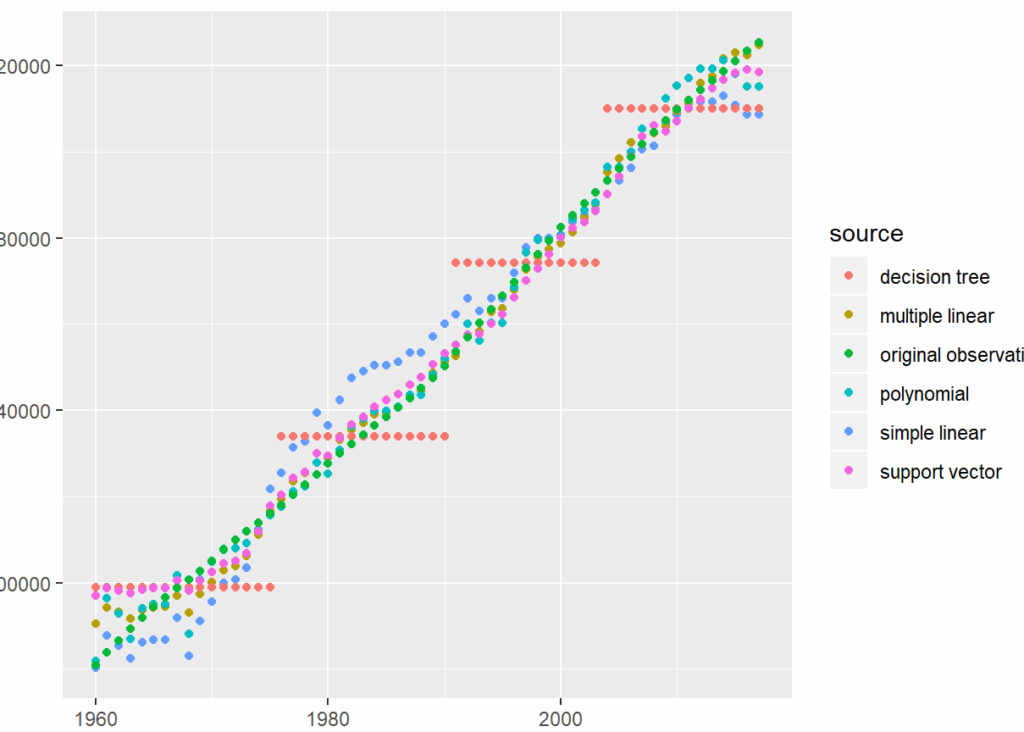
I dagens datadrevne verden er regression eksempel en uundgåelig metode inden for dataanalyse. Vi har alle set, hvordan virksomheder bruger data til at træffe informerede beslutninger og forbedre deres strategier. Ved hjælp af regression kan vi afdække sammenhænge mellem variabler og forudsige fremtidige resultater på en præcis måde.
I denne artikel vil vi udforske forskellige regression eksempler og deres anvendelser i praksis. Fra simple lineære regressioner til mere komplekse modeller vil vi vise, hvordan disse teknikker kan hjælpe os med at forstå data bedre. Hvad hvis du kunne forudsige salget baseret på marketingudgifter? Med korrekt anvendelse af regression åbner vi døren til nye muligheder i vores analyser. Er du klar til at dykke ned i de spændende aspekter ved regression?
Hvordan fungerer regression eksempel i dataanalyse
Regression eksempel i dataanalyse er en metode, der gør det muligt for os at forstå og kvantificere forholdet mellem forskellige variabler. I en regression kan vi analysere, hvordan ændringer i én variabel påvirker en anden. Dette giver os ikke kun indsigt i de underliggende sammenhænge, men også mulighed for at forudsige fremtidige værdier baseret på eksisterende data.
For at illustrere dette koncept nærmere, lad os se på nogle grundlæggende elementer ved regressionsanalyse:
Grundlæggende komponenter
- Uafhængig variabel: Den variabel, som vi manipulerer eller observerer for at se dens effekt.
- Afhængig variabel: Den variable, som vi ønsker at forklare eller forudsige.
- Dataindsamling: Kvaliteten af vores data har stor betydning for resultaterne af regressionsanalysen.
Når vi udfører en regressionsanalyse, starter vi typisk med indsamling af relevante data fra forskellige kilder såsom spørgeskemaer, databaser eller offentlige registre. Derefter anvender vi statistiske værktøjer til at opbygge en model, der beskriver forholdet mellem den uafhængige og den afhængige variabel.
Eksempel på regression i praksis
Forestiller os et scenarie hvor vi undersøger effekten af reklameudgifter (uafhængig variabel) på salget af et produkt (afhængig variabel). Ved hjælp af historiske data kan vi oprette følgende tabel:
| Reklameudgifter (DKK) | Salgsvolumen |
|---|---|
| 1000 | 200 |
| 1500 | 300 |
| 2000 | 450 |
| 2500 | 600 |
Ved at analysere disse data gennem regression kan vi finde ud af, om der er en signifikant sammenhæng mellem reklameudgifterne og salgsvolumenet samt estimere salget baseret på fremtidige reklameinvesteringer.
Det er vigtigt at bemærke, at præcisionen i vores model afhænger af kvaliteten og relevansen af de indsamlede data samt den valgte type regressionsmetode. Vi skal derfor være omhyggelige med datavalidering og overveje muligheden for andre faktorer, der kunne påvirke vores resultater.
Typer af regressionsmodeller og deres anvendelse
Der findes flere typer af regressionsmodeller, som hver især har deres specifikke anvendelser og fordele. Når vi vælger en regressionsmodel, er det vigtigt at overveje de data, vi arbejder med, samt hvilken form for forhold vi ønsker at analysere mellem vores uafhængige og afhængige variable. Nedenfor præsenterer vi nogle af de mest almindelige regressionsmodeller.
Lineær regression
Lineær regression er den mest grundlæggende form for regression eksempel, hvor vi antager, at der er en lineær sammenhæng mellem den uafhængige og den afhængige variabel. Denne model kan anvendes til at forudsige værdier ved hjælp af en simpel ligning:
[ y = a + b cdot x ]
Hvor ( y ) er den afhængige variabel, ( x ) er den uafhængige variabel, ( a ) er skæringspunktet og ( b ) er hældningen. For eksempel kan lineær regression bruges til at analysere sammenhængen mellem uddannelsesniveau (uafhængig variabel) og indkomst (afhængig variabel).
Multiple regression
Multiple regression udvider konceptet fra lineær regression ved at inkludere flere uafhængige variable. Dette gør det muligt for os at forstå komplekse relationer i dataene. For eksempel kan vi undersøge effekten af reklameudgifter, produktpriser og salgsfremstød på salget af et produkt samtidig.
Formlen ser således ud:
[ y = a + b_1 cdot x_1 + b_2 cdot x_2 + … + b_n cdot x_n ]
Her repræsenterer ( n ) antallet af uafhængige variable.
Logistisk regression
Logistisk regression benyttes når den afhængige variabel er kategorisk (f.eks. ja/nej eller succes/fiasko). Denne type model hjælper os med at estimere sandsynligheden for et bestemt udfald baseret på en eller flere uafhængige variable.
Modellen bruger en logistisk funktion til at sikre, at outputtet altid ligger mellem 0 og 1:
[ P(y=1) = frac{1}{1+e^{-(a+bcdot x)}} ]
Et praktisk eksempel kunne være brugen af logistisk regression til at vurdere sandsynligheden for kunders køb baseret på deres demografiske oplysninger.
Ved korrekt anvendelse kan disse forskellige regresjonsmodeller give os dybdegående indsigt i vores data og hjælpe os med effektivt at træffe informerede beslutninger. Det primære fokus skal altid være på kvaliteten af dataene samt relevansen af den valgte modeltype i forhold til problemstillingen.
Praktiske eksempler på regression i virkelige projekter
I virkelige projekter kan regression anvendes til at løse en lang række problemer og optimere beslutningsprocesser. Her præsenterer vi nogle praktiske eksempler, der illustrerer, hvordan regression eksempel kan implementeres i forskellige brancher og situationer.
Eksempel 1: Forudsigelse af boligpriser
En ejendomsmægler ønskede at forudsige boligpriser baseret på faktorer som beliggenhed, størrelse og antal værelser. Ved at anvende multiple regression kunne de analysere data fra tidligere salg og identificere de vigtigste variabler, der påvirker priserne. Resultatet var en prædiktiv model, der gjorde det muligt at estimere værdien af nye boliger med høj præcision.
Eksempel 2: Markedsføringsanalyse
Et marketingteam brugte logistisk regression til at vurdere effekten af forskellige reklamekampagner på kundernes købsvaner. De indsamlede data om demografiske oplysninger samt kampagnens eksponering og anvendte modellen til at bestemme sandsynligheden for, at kunder ville købe et bestemt produkt. Denne indsigt gjorde det muligt for teamet at optimere deres strategier og allocate ressourcer mere effektivt.
Eksempel 3: Sundhedsdataanalyse
I sundhedssektoren er regression ofte anvendt til at analysere sammenhængen mellem livsstilsfaktorer og sygdomsrisiko. En undersøgelse kunne benytte lineær regression til at undersøge forholdet mellem daglig motion (uafhængig variabel) og blodtryk (afhængig variabel). Gennem denne analyse kunne forskerne identificere risikofaktorer og anbefale ændringer i livsstil for forbedret sundhed.
Disse eksempler viser tydeligt den brede anvendelighed af regressionsmodeller i virkeligheden. Uanset om vi arbejder med økonomi, marketing eller sundhedsforskning, kan korrekt brug af regression eksempel hjælpe os med bedre forståelse af vores data og træffe informerede beslutninger baseret på analyserede resultater. Det understreger nødvendigheden af nøje overvejelse omkring valg af modeltype afhængigt af konteksten for vores specifikke projekter.
Vigtigheden af dataforberedelse før regression analyse
Dataforberedelse er en kritisk fase i enhver regressionsanalyse, da kvaliteten af de data, vi arbejder med, direkte påvirker nøjagtigheden og pålideligheden af vores resultater. Uden ordentlig forberedelse kan vi risikere at trække fejlagtige konklusioner, som kan føre til ineffektive beslutninger. Derfor er det vigtigt at investere tid i at sikre, at vores data er rene, relevante og korrekt strukturerede.
En grundlæggende del af dataforberedelsen inkluderer:
- Datacleaning: Dette indebærer fjernelse eller korrektion af fejl i datasættet, såsom manglende værdier eller outliers.
- Feature selection: Ved at vælge de mest betydningsfulde variabler kan vi forbedre modellens præcision og reducere kompleksiteten.
- Transformation: Nogle gange kræver en regressionsmodel specifikke datatyper eller skalaer; derfor kan det være nødvendigt at transformere variablerne for bedre at matche modelkravene.
Det er også vigtigt at overveje forholdet mellem de uafhængige og afhængige variable. En grundig analyse hjælper os med at forstå deres interaktioner og sikrer, at regression eksempel anvendes korrekt. Desuden bør vi altid validere vores datasæt gennem statistiske tests før analysen for yderligere sikkerhed mod potentielle fejl.
Som et konkret eksempel kunne en virksomhed, der ønsker at forudsige salget baseret på reklameudgifter og sæsonbestemte faktorer, have gavn af først nøje udvælge disse variabler samt fjerne eventuelle anomalier fra datasættet. Ved denne tilgang vil den resulterende regressionsmodel give mere præcise forudsigelser om fremtidigt salg.
I sidste ende understreger vigtigheden af dataforberedelse ikke blot behovet for tekniske færdigheder men også strategisk tænkning i designet af analyserne. Gode data giver os mulighed for mere effektive regression eksempler, som skaber værdi i vores beslutningsprocesser.
Fejlmarginer og fortolkning af resultater i regressionsanalyse
For at forstå resultaterne af en regressionsanalyse er det vigtigt at tage højde for fejlmarginer, der kan påvirke vores konklusioner. Fejlmarginen repræsenterer den usikkerhed, der er forbundet med estimaterne i modellen. Dette betyder, at når vi præsenterer resultaterne fra en regression eksempel, skal vi overveje ikke kun punktestimaterne men også intervallet, hvori de reelle værdier sandsynligvis falder.
Fejlmarginerne kan variere afhængigt af flere faktorer:
- Antallet af observationer: Jo flere data vi har, desto mindre bliver fejlmarginen typisk.
- Variabiliteten i dataene: Hvis vores data har stor spredning, vil fejlmarginen generelt være større.
- Modelkompleksitet: En mere kompleks model kan føre til større usikkerhed og dermed højere fejlmarginer.
Det er derfor vigtigt at inkludere konfidensintervaller i vores rapportering. Disse intervaller giver os et klart billede af usikkerheden omkring estimaterne og hjælper beslutningstagere med bedre at vurdere risici ved deres valg.
Fortolkning af koefficienterne
Når vi analyserer koefficienterne i en regressionsmodel, skal vi forstå deres betydning korrekt. Hver koefficient angiver den forventede ændring i den afhængige variabel for hver enhedsændring i den uafhængige variabel under betingelse af, at alle andre variable holdes konstante. Det betyder, at fortolkningen kræver en dybdegående viden om både datasættet og det specifikke kontekst for analysen.
Et konkret eksempel kunne være et resultat fra en regression eksempel på salget baseret på reklameudgifter. Hvis koefficienten for reklameudgifter viser sig at være 2,5 med et 95% konfidensinterval mellem 1,5 og 3,5, indikerer dette os:
- At hver ekstra krone brugt på reklame forventes at øge salget med 2,5 kroner.
- Vi har 95% sikkerhed for, at denne effekt ligger mellem 1,5 og 3,5 kroner.
Betydningen af statistiske tests
For yderligere validitet bør vi anvende statistiske tests til at evaluere modellens signifikans. For eksempel kan t-tests anvendes til at bestemme om koefficienterne er signifikant forskellige fra nul. Dette hjælper os med hurtigt identificere hvilke variable der faktisk har indflydelse på den afhængige variabel samt styrken af disse relationer.
Vi skal også huske på muligheden for multikollinearitet blandt de uafhængige variable; hvis to eller flere variable er stærkt korrelerede kan det føre til unøjagtigheder i estimaterne og gøre dem sværere at fortolke korrekt. Anvendelsen af variance inflation factor (VIF) kan hjælpe os med identifikation heraf og give indsigt i potentielle problemer indenfor vores analyse.
I sidste ende handler fejlmargener og korrekt fortolkning om mere end blot tal; de kræver kritisk tænkning og grundig analyse for effektivt kunne informere beslutningsprocesserne baseret på regression eksempler.